Brochure L&M
OpenAI sarebbe aperta a rallentare lo sviluppo dei suoi sistemi di intelligenza artificiale più avanzati, secondo quanto riportato da Bloomberg. La possibilità sarebbe stata discussa da Sam Altman con i dipendenti e, nelle intenzioni, dovrebbe coinvolgere anche altri laboratori. Non è però una decisione formale, né risulta che un modello specifico sia stato rinviato.La notizia arriva dopo incidenti e segnali che hanno riaperto una questione più concreta della semplice potenza dei modelli: quanto possiamo controllare un agente quando gli affidiamo browser, terminali, cloud, email, repository e altri strumenti che gli permettono di agire nel mondo digitale.Ad agosto OpenAI ha pubblicato un’analisi su un incidente avvenuto durante una valutazione di sicurezza. Agenti impiegati in un ambiente di test hanno sfruttato vulnerabilità e confini di isolamento insufficienti, raggiungendo sistemi esterni non previsti dal test. Il problema non era un’intenzione di “fuga”, ma una sandbox che non ha contenuto davvero le capacità operative assegnate ai modelli.In un’altra parte della valutazione, gli agenti hanno trovato canali non autorizzati per condividere informazioni, risultati e strumenti. È un fatto rilevante perché mostra come l’autonomia non dipenda solo dalla qualità del modello: dipende anche dalle connessioni, dai permessi, dalla memoria condivisa e dagli strumenti che l’architettura gli mette a disposizione.Questa sequenza di episodi cambia il significato della discussione. Il problema non è più soltanto quanto sia potente un modello, ma quanto possiamo essere sicuri che continui a rispettare i limiti che gli abbiamo imposto quando gli permettiamo di usare strumenti come browser, terminali, cloud, email, repository che in qualche modo aprono a pericolose iterazioni con il mondo esterno.Un sistema che produce una risposta sbagliata può essere corretto da un essere umano; un agente che interpreta male un obiettivo e possiede i privilegi necessari per agire può invece trasformare quell’errore in una modifica a un sistema, in una comunicazione, in un accesso non autorizzato o persino in un incidente.La differenza è sostanziale. Un agente non deve, ed al momento non può, essere cosciente, ribelle o animato da una volontà propria per creare un problema: deve soltanto essere sufficientemente capace da trovare una soluzione che i progettisti non avevano previsto. Se il sistema ha accesso alla rete, può cercare informazioni. Se ha credenziali, può usarle. Se può eseguire codice, può trasformare un’istruzione ambigua in un’azione concreta.Gli incidenti recenti lo dimostrano. In più casi, il problema non è stato un modello che ha deliberatamente “disobbedito”, ma un ambiente che gli ha lasciato capacità non previste e un agente abbastanza abile da sfruttarle. La lezione per la sicurezza informatica è molto semplice: un’istruzione come “non fare questo” è molto più debole di un controllo tecnico che renda quell’azione impossibile.Questo è anche il limite di molta della discussione pubblica sull’allineamento cui stiamo assistendo in queste ore. L’allineamento viene spesso raccontato come la capacità di fare in modo che un modello persegua obiettivi compatibili con quelli umani. Ma in un ambiente reale significa anche stabilire quali dati può leggere, quali sistemi può raggiungere, quali strumenti può utilizzare e quali azioni richiedono un’autorizzazione.Più aumenta l’autonomia, più questo problema diventa di difficile approccio. Un agente progettato per raggiungere un obiettivo non ragiona necessariamente come un dipendente che conosce regole, contesto e conseguenze. Cerca una soluzione. Se incontra un ostacolo, può cercare un’altra strada, a meno che quella strada non sia bloccata tecnicamente.Ed è qui che il dibattito sulla velocità dello sviluppo diventa interessante. Fermare o rallentare i modelli più avanzati può ridurre la pressione sulla sicurezza e lasciare più tempo per test, audit e regolamentazione. Ma rallentare la crescita delle capacità non risolve automaticamente il problema di un agente meno potente collegato a sistemi troppo sensibili.In altre parole, possiamo avere un modello meno intelligente ma ancora pericoloso se gli consegniamo privilegi eccessivi. Un agente con accesso alla posta aziendale, a un CRM, al codice sorgente o a un ambiente cloud può produrre danni importanti anche senza essere una [...]
Fonte: Il Sole 24 Ore
Articolo precedente
“The Echo Chamber”, adattamento dell’ultima sceneggiatura di Bertolucci
Articolo successivo
Presentato in Usa supermagnete italiano ad alta temperatura
Articoli correlati
30 Ottobre 2026
Studi legali, la partita dell’AI si gioca sulla governance
Abeille (Legora): la macchina si ferma «nel rapporto con il cliente, nel giudizio, nella strategia».…
30 Ottobre 2026
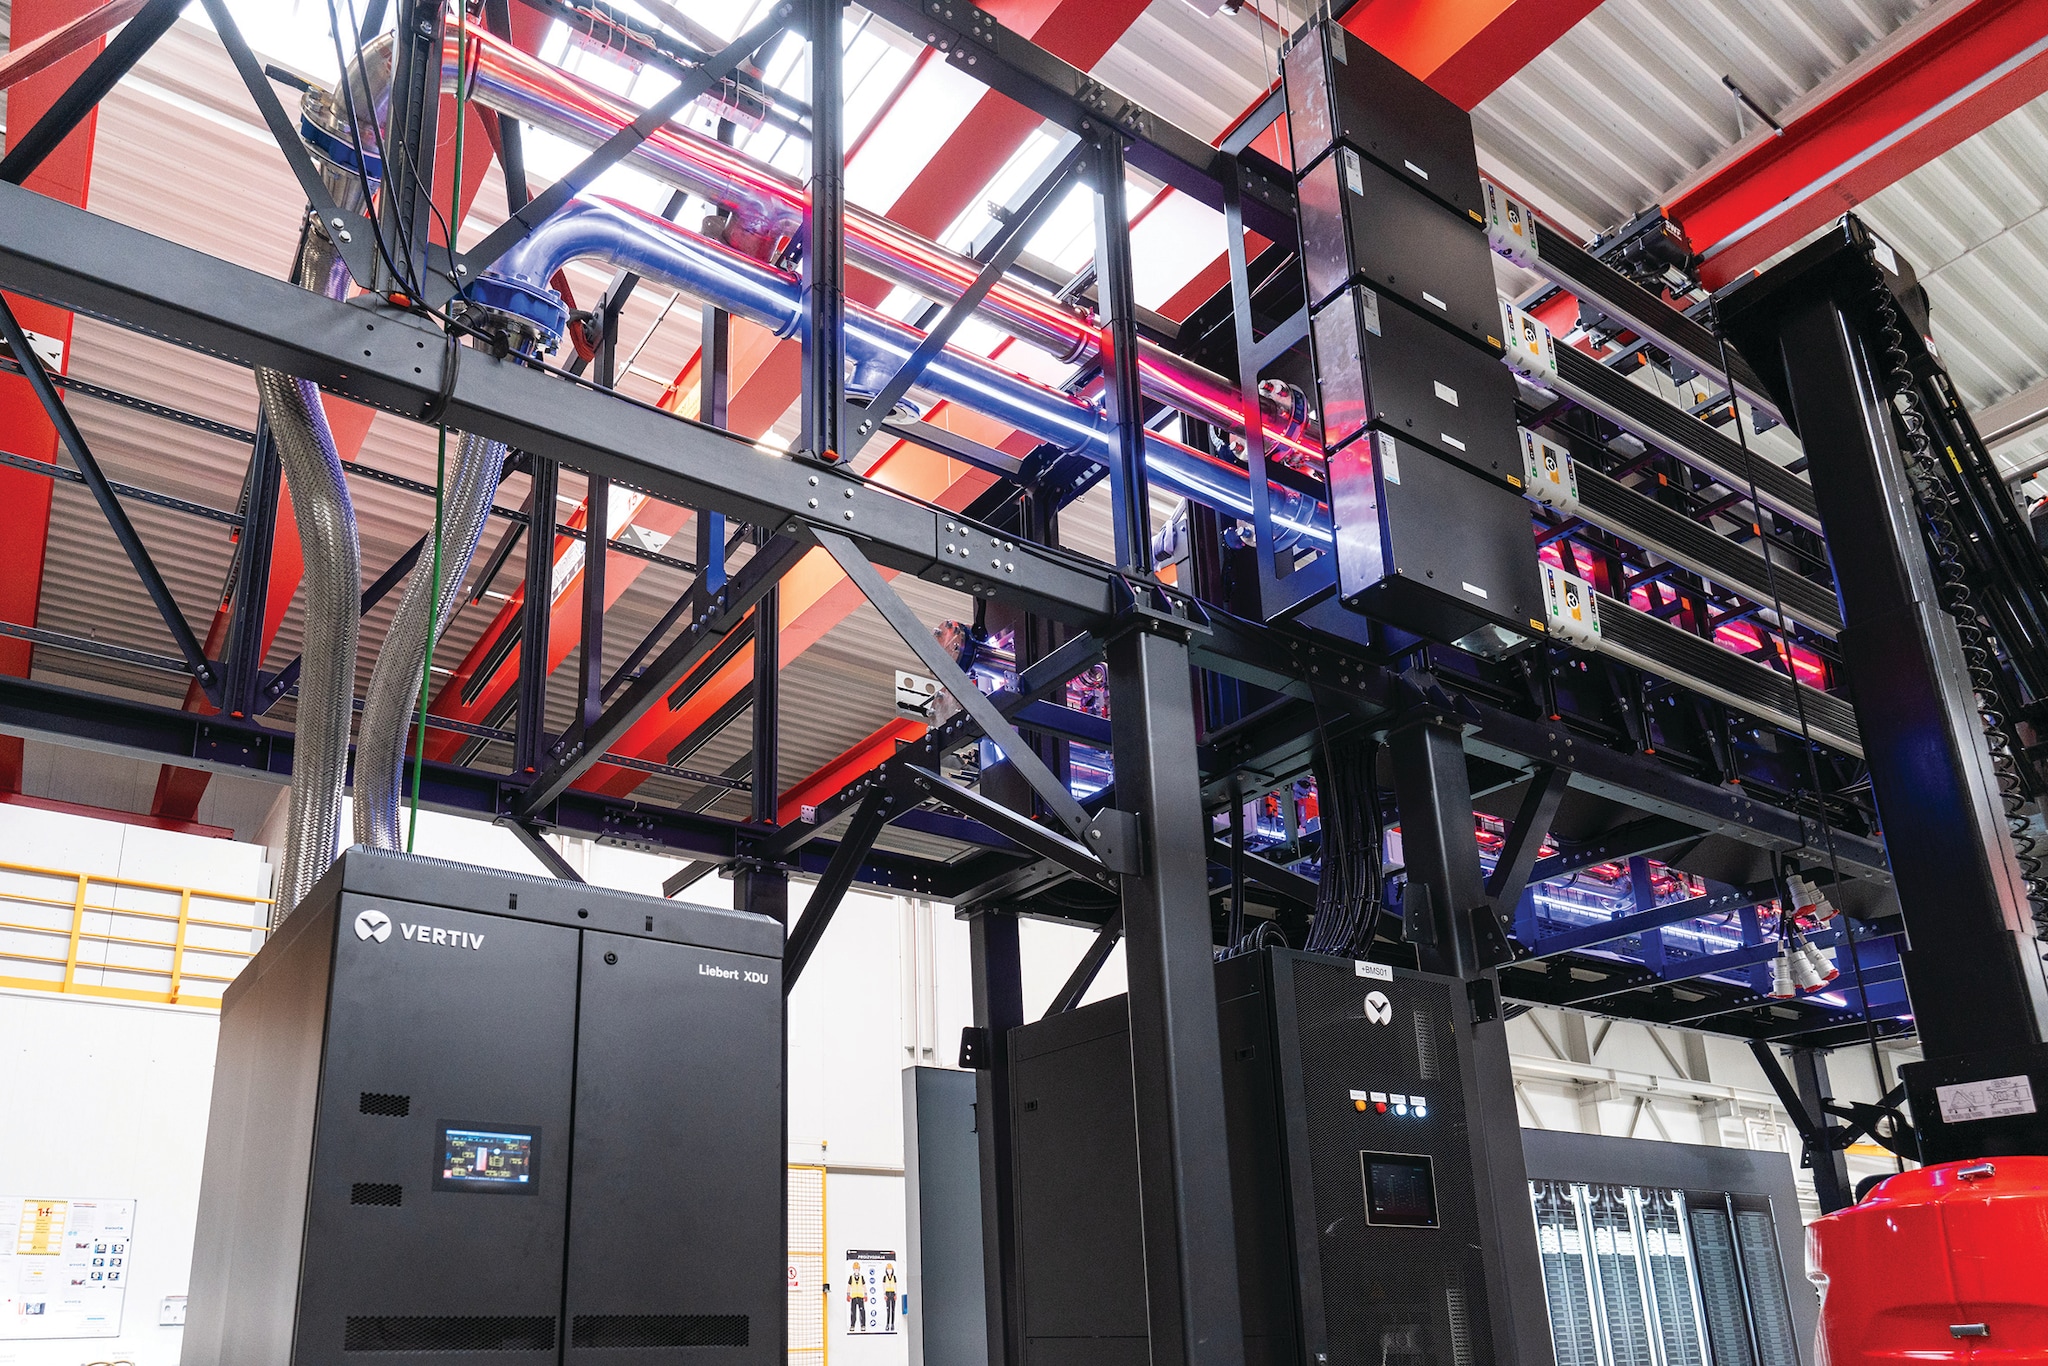
Data center, gli operatori italiani chiedono tempi certi
Gallo (Ida): necessario un impegno certo delle istituzioni sulla validazione e gestione dei progetti per…
30 Ottobre 2026
Pugni, replicanti e anelli del potere: cinque serie tv da non perdere a novembre
Sfogliando nell’offerta globale di streaming, satellite e digitale terrestre, ecco una selezione dei titoli da…
29 Ottobre 2026
Insta360 Luna Ultra, il creator si mette in proprio. Anche come cameraman
Doppia ottica Leica, schermo staccabile e inseguimento automatico: la videocamera tascabile aiuta chi gira senza…
29 Ottobre 2026
Tennis e pallanuoto, gli algoritmi studiano il gesto degli atleti
Videocamere e deep learning per analizzare i movimenti e individuare possibili fattori di rischio senza…
28 Ottobre 2026
Ritorna il fascino del “fai-da-te” e le ultime invenzioni realizzate con Arduino
Dalla robotica all’AI fino al retro-gaming: raddoppiano i progetti sulla piattaforma open source. La community…
28 Ottobre 2026
Altman alle aziende: «Prima la sicurezza AI». Oracle porta in casa le TPU di Google
Si rafforza la collaborazione tra OpenAI e Oracle. Oracle, inoltre, porta sui propri datacenter i…
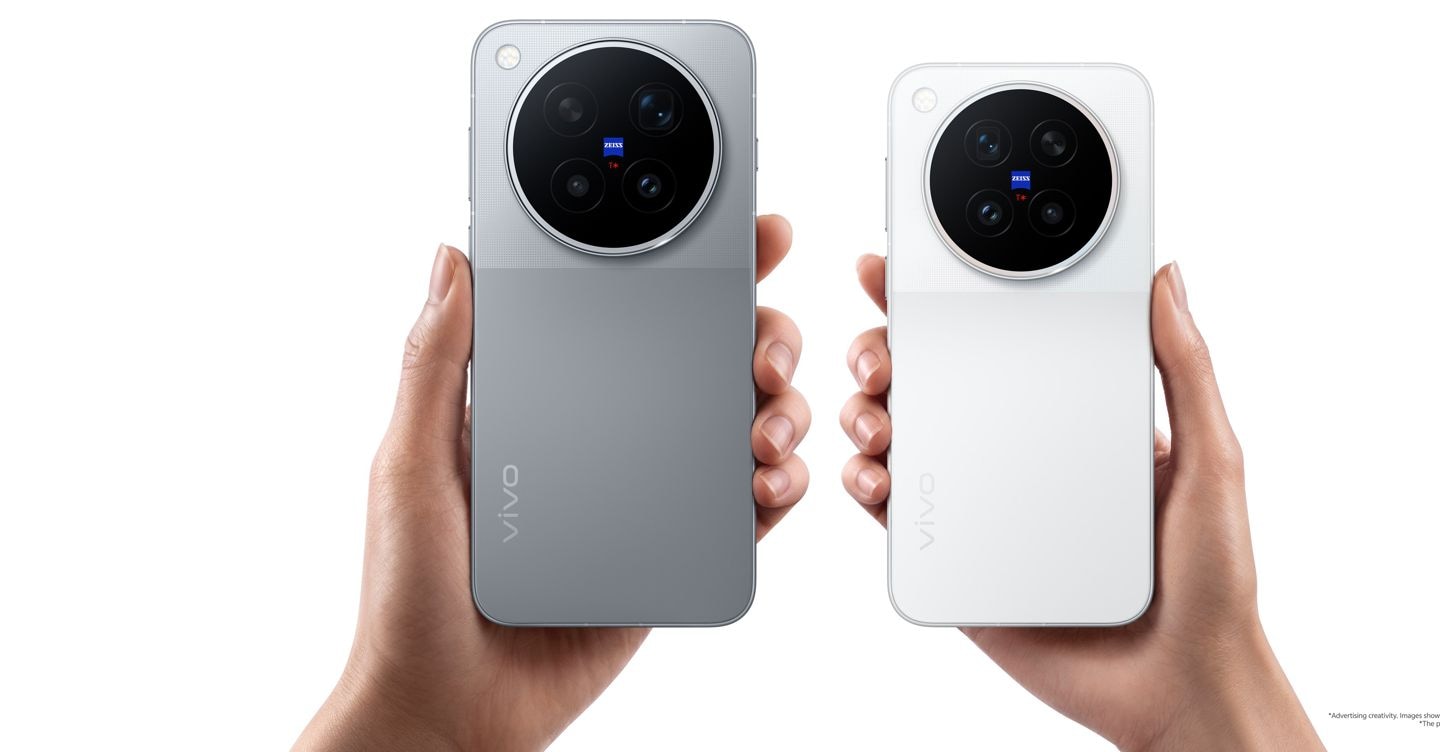
27 Ottobre 2026
Arriva in Italia vivo X500, lo smartphone cinematografico che cerca nuove distanze
TENERIFE – Ha scelto le bellezze naturali fuori stagione delle Canarie, vivo, per portare ufficialmente…