 Brochure L&M


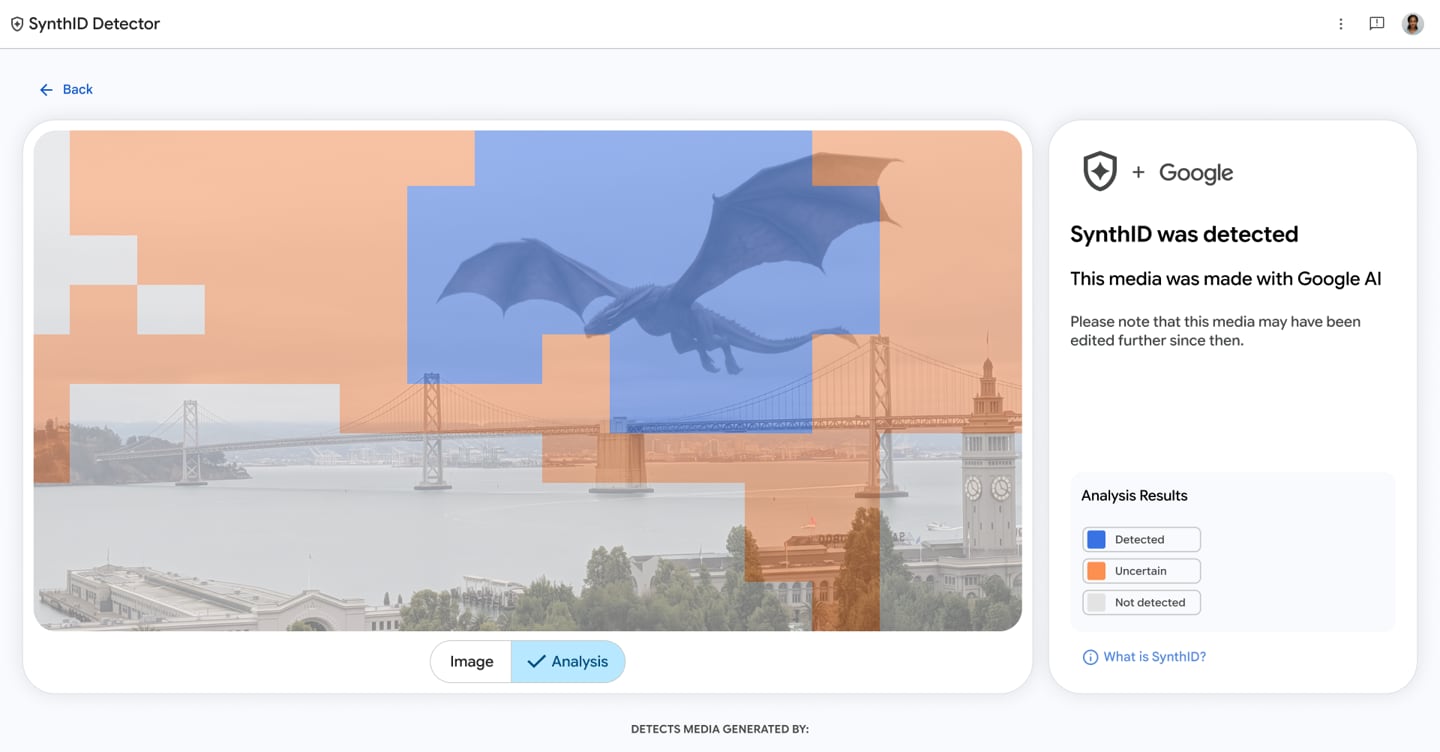
Le filigrane digitali possono aiutare a riconoscere i contenuti generati dall’AI, ma restano dubbi sull’affidabilità: falsi positivi, marchi rimovibili e sistemi diversi tra le Big Tech. L’assenza di un watermark non prova un’origine umana, mentre la sua presenza non basta a dimostrare una frode.
Google apre a tutti la verifica dei contenuti generati dall’intelligenza artificiale. Da ieri SynthID Detector è online e consente di controllare gratuitamente – dopo il login e per ora in inglese – immagini, video e audio. Sostanzialmente individua i watermark dei generatori di immagini, video e audio di Google e dei partner OpenAI, NVIDIA e Kakao. I testi restano esclusi dal portale anche perché sono un discorso a parte. Nei giorni scorsi dopo OpenAI sulla scia di Anthropic ha annunciato che nelle prossime settimane introdurrà una filigrana nelle risposte compatibili di ChatGPT e Codex nell’Unione europea, in risposta all’AI Act. Il suo sistema, textGrain, modifica leggermente le probabilità di scelta delle parole, lasciando un’impronta statistica. Qualcosa quindi si sta muovendo lato Big tech sul fronte della trasparenza e della riconoscibilità dei contenuti generati dall’Ai. Ma la domanda resta la stessa: sarà davvero più difficile spacciare un contenuto artificiale per umano, oppure i controlli alimenteranno nuovi equivoci? Ma sopratutto, perché non sono tutti d’accordo? Partiamo da SynthID
SynthID inserisce un segnale invisibile nei pixel e nelle componenti sonore durante la generazione. La filigrana è progettata per resistere a ritagli, filtri e compressione. Il detector cerca quel marchio: non identifica qualsiasi contenuto prodotto dall’AI. Se non trova nulla, il file potrebbe provenire da un modello che non usa SynthID oppure essere stato modificato fino a indebolire il segnale. L’assenza del watermark quindi non garantisce un’origine umana. Il rischio è usare quella traccia come prova di una scorrettezza.
La stessa Google dichiara che il suo non è un rilevatore di AI: il risultato è solo “watermark trovato / non trovato”. Se il watermark non c’è, non significa che il contenuto sia umano. Può venire da un modello che non usa SynthID, oppure il segnale si è rovinato con le modifiche. Inoltre lo strumento non distingue un contenuto creato da zero con l’AI da uno solo ritoccato con l’AI. Inoltre, regge bene alle modifiche normali (ritagli, filtri, compressione, MP3), non a chi lo vuole togliere apposta. Alcuni studi preliminari sostengono che protegge dal falso fatto per distrazione, non da quello fatto con cattive intenzioni.
Quanto al testo, nei test OpenAI, dichiara una soglia di falsi positivi dell’1%, il riconoscimento raggiunge circa il 95% su brani da 400 token in ambiti come la psicologia. In un’altra prova, sostituire un quarto delle parole con sinonimi lo fa scendere dal 92% al 17%. Chi vuole barare ha margine; chi viene segnalato può avere rielaborato il testo. Il detector partirà quindi con accesso riservato a ricercatori e organizzazioni esperte.
L’altro problema è che non sono tutti d’accordo. Apple ha detto che lo supporterà più avanti nel 2026, quindi oggi non c’è ancora. Meta sviluppa strumenti aperti propri, Video Seal e AudioSeal. Microsoft 365 abbina metadati di provenienza, marchi visibili e avvisi vocali. Sono sistemi complementari, con limiti diversi. Il rischio insomma è che la “caccia alle streghe” ai contenuti artificiali si riveli insomma tanto confusionaria quanto controproducente.
Fonte: Il Sole 24 Ore
Articolo precedente
Legge elettorale, oggi ultimo atto: voto finale alle 12.30
Articoli correlati
8 Ottobre 2026
Cybersecurity, imprese più preparate ma ancora fragili nella gestione delle crisi
Il report EY Cyber Barometer 2025, su oltre 300 società italiane, rileva difese più strutturate…
8 Ottobre 2026
La prova di iPhone 18 Pro Max: evoluzione di sostanza
Il nuovo modello è una conferma dell’innovazione dei modelli Pro. Le novità più interessanti sono…
7 Ottobre 2026
Mistral Large 4, che cosa offre il gigante europeo dell’intelligenza artificiale?
Il modello francese da mille miliardi di parametri promette prestazioni competitive nel software, nella finanza…
7 Ottobre 2026
L’intelligenza artificiale può scrivere un libro da sola?
Il caso del romanzo C’était ça ou mourir, squalificato dal premio letterario Goncourt, ha mostrato…
6 Ottobre 2026
Testi scritti dall’Ai, perché i nuovi controlli si possono aggirare
Anche OpenAI comincia a firmare i testi della propria intelligenza artificiale per renderli distinguibili da…
6 Ottobre 2026
Dalla stampa UV alle magliette: Anker porta una piccola fabbrica sul tavolo degli artigiani digitali
I mercatini in giorni prefissati della settimana o in occasione di sagre e festività, più…
5 Ottobre 2026
I data center per l’AI: come sono oggi e come saranno fra cinque anni
Viaggio dentro la facility di Vertiv a Rugvica, Croazia, dove si costruiscono le infrastrutture per…
4 Ottobre 2026
Le relazioni non sono una perdita di tempo: rendono possibile la performance
Per Daniel Coyle solo prestando attenzione reale si costruisce un ambiente capace di affrontare la…


